

Qwen3-TTS
Qwen3-TTS 是由阿里云 Qwen 团队开发的开源语音合成模型系列,支持稳定、富有表现力和流式语音生成、自由形式语音设计以及生动语音克隆。
该模型采用了创新的统一架构,将文本、图像、视频和音频的理解能力深度融合,实现了真正意义上的“原生全模态”

MiMo-V2-TTS官网:小米于2026年3月发布的自研语音合成大模型
小米MiMo-V2-TTS是小米于2026年3月发布的自研语音合成大模型,代表了语音生成技术的质变。该模型基于前沿的Audio Tokenizer和多码本语音-文本联合建模架构,从底层重构了语音生成的逻辑。通过对超过上亿小时的高质量语音数据进行大规模预训练,MiMo-V2-TTS彻底解决了传统语音合成中存在的机械感与单调性。它不仅能够在高保真的离散Token空间中精准还原语音细节,更引入了多维度强化学习机制,使模型在生成过程中能直接响应语音相关的奖励信号,从而实现了极高的音质稳定性与自然度。作为小米大模型家族的重要成员,它不仅是技术上的突破,更是为AI智能体赋予“人类灵魂”的关键一步,能够提供极其逼真且富有层次感的听觉体验,让用户在与AI交流时感受到前所未有的亲切感与沉浸感。
MiMo-V2-TTS官网: https://mimo.xiaomi.com/mimo-v2-tts

好的,我已经收集了足够的信息,现在开始撰写这篇详细的中文博客文章。
小米 MiMo-V2-TTS 深度评测:能说会唱还懂方言,国产语音合成的新高度
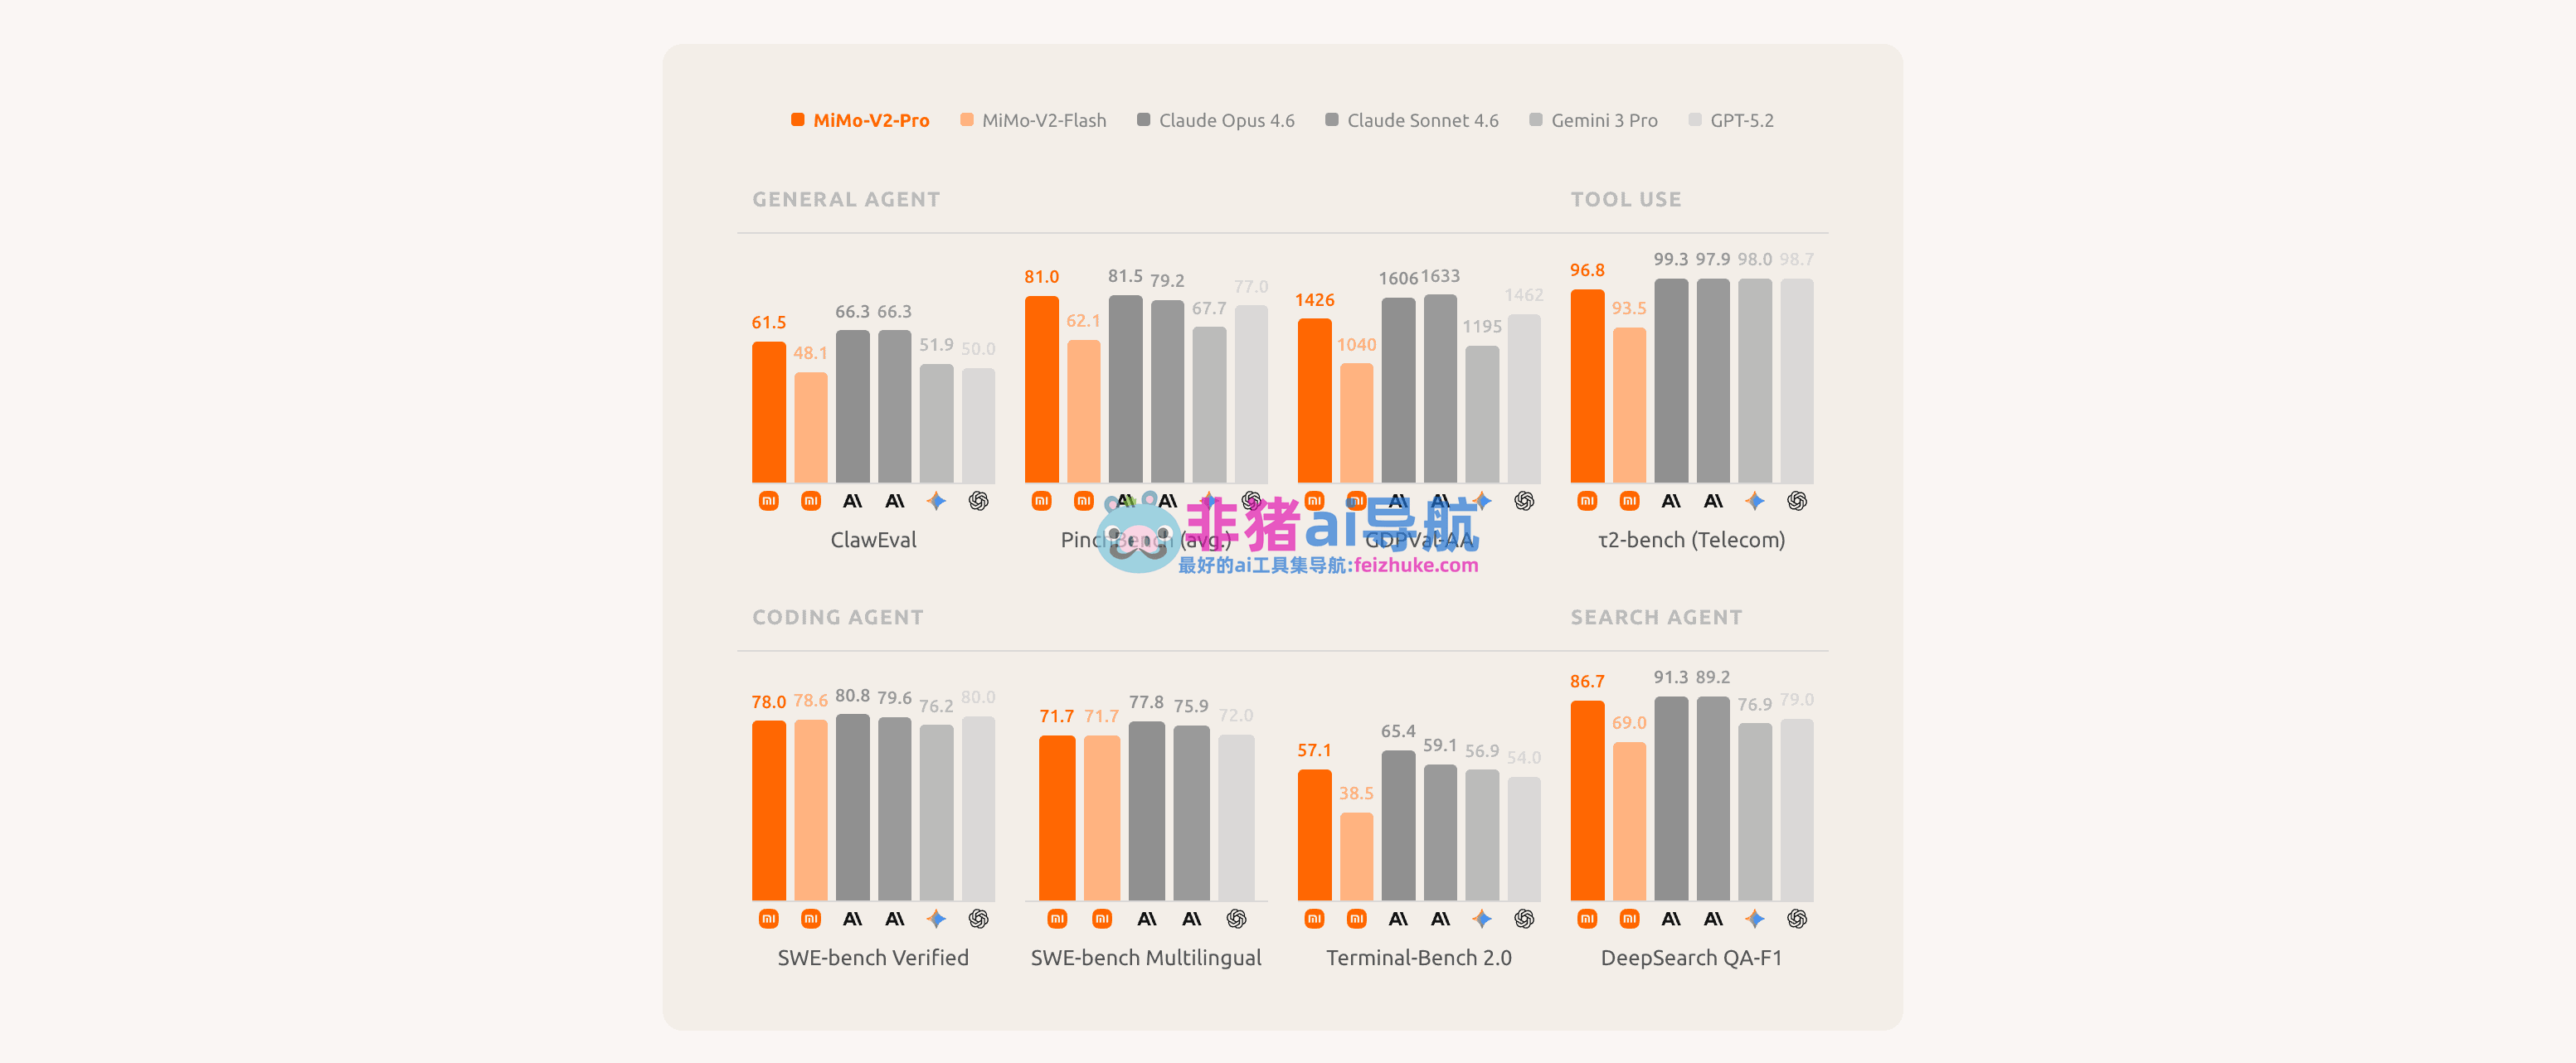
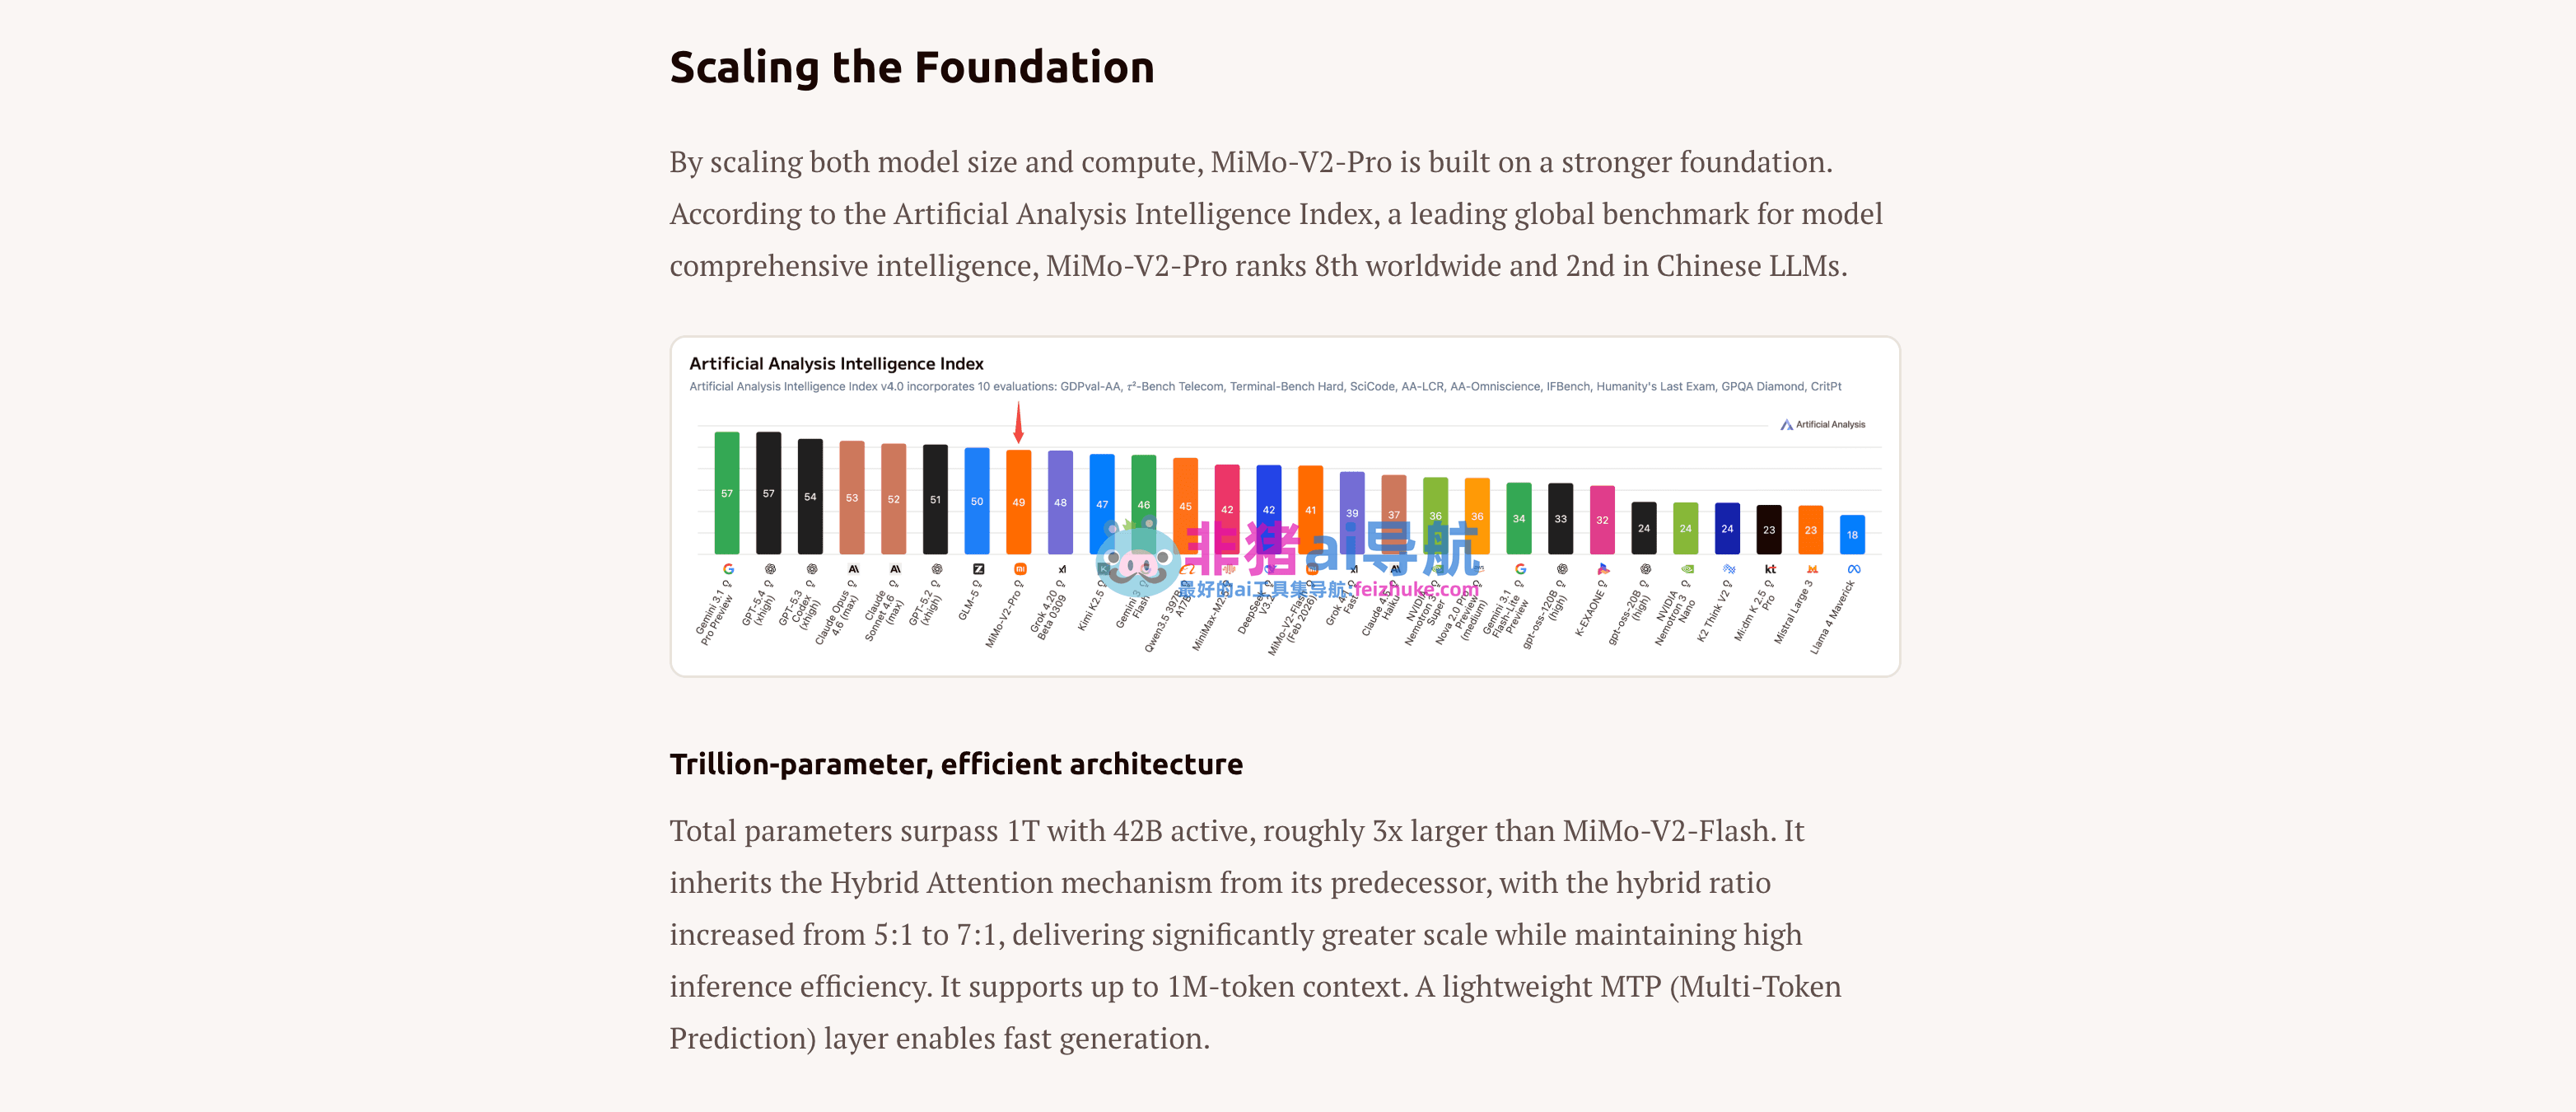
2026年3月19日凌晨,小米悄然上线了三款自研大模型——MiMo-V2-Pro、MiMo-V2-Omni 与 MiMo-V2-TTS,后者是本篇的主角。在这个 Agent 时代全面爆发的节点,小米选择用一款语音合成大模型来补齐其 AI 生态的”开口说话”能力,这个时机选得相当精准。MiMo-V2-TTS 一经亮相,就以”能说会唱还能讲方言”的特性引发了广泛关注,东北话、四川话、河南话、粤语、台湾腔,甚至还能唱歌,这在国内 TTS 赛道上确实属于少见的综合能力组合。
本文将从技术架构、核心功能、实际体验到横向对比,做一次完整的拆解与评估。
要理解 MiMo-V2-TTS 为什么好用,得先搞清楚它的技术路线和其他 TTS 模型有何不同。
MiMo-V2-TTS 的底层基础是小米自主研发的 Audio Tokenizer,配合多码本语音-文本联合建模架构(Multi-Codebook Speech-Text Joint Modeling)。简单说,这套架构的核心逻辑是把语音和文本放在同一个语义空间里联合建模,而不是先把文本转成中间表示再合成语音的传统两阶段流水线。这种联合建模方式的好处在于:模型对文本语义的理解会直接影响语音生成的表达方式,而不是脱钩处理。
多码本(Multi-Codebook)的设计则是另一个关键。与单码本相比,多层码本能在高保真的离散 token 空间中对语音进行建模,充分保留原始语音中的丰富信息——包括音色细节、韵律节奏、情感状态等。这也是后续强化学习阶段能够有效发挥作用的前提,因为奖励信号可以直接作用于语音相关的 token 层面。
数据规模是 AI 模型能力的天花板之一。MiMo-V2-TTS 基于上亿小时的语音数据进行大规模预训练,这一数量级在业界属于较高水平。海量数据覆盖了不同说话人、不同场景、不同语言风格,使模型具备了跨域泛化的基础——无论是日常对话、新闻播报、情感表达还是歌声合成,模型都有对应的声学知识储备。
预训练构建的是能力上限,而强化学习则负责打磨输出质量的下限。小米在 MiMo-V2-TTS 的后训练阶段引入了多维度强化学习(Multi-dimensional Reinforcement Learning),并围绕以下五个核心维度持续优化:
得益于多层码本架构,强化学习的奖励信号可以直接作用于生成过程,而不是只在最终音频层面进行评估,这让多维度优化信号真正落到实处。
MiMo-V2-TTS 最核心的能力之一,是支持从整体到局部的多层次风格控制。用户可以通过自然语言指令设定整体基调(比如”用新闻播音员的风格”、”用温柔耐心的口吻”),同时对句子内部的局部片段进行细粒度情绪调节。
举个具体场景:同一句话,前半段是陈述信息的平稳语气,后半段突然转向兴奋的感叹,MiMo-V2-TTS 能在不打断节奏的情况下完成这种语气转折,真实还原了人类说话时情绪流动的自然状态。这种句内情感递变的能力,对于有声书制作、角色配音、情感客服等场景价值极高。
MiMo-V2-TTS 原生支持普通话之外的多种中文方言,目前已确认包括:
这一能力的价值在于,方言不只是发音口音的变化,还涉及语调规律、语气词使用习惯、停顿节奏等深层语言特征。MiMo-V2-TTS 支持在角色扮演场景中根据文本内容自动切换方言语调,结合情感控制模块,可以生成极具地域特色的声音输出,大幅提升人机交互的亲和力。
这是 MiMo-V2-TTS 最令人眼前一亮的特性之一。大多数 TTS 模型在面对歌词合成时要么完全不支持,要么产出平板无韵律的机器音,而 MiMo-V2-TTS 能够准确表达音高和节奏,实现真正意义上的高质量歌声合成。
能做到这一点,背后是多码本建模架构对音频精细结构的充分保留——音高(Pitch)和时值(Duration)本质上都是音频的时序特征,在高保真 token 空间里才能被有效建模和控制。这让 MiMo-V2-TTS 具备了从说话到演唱的统一生成能力,而不是两套独立的系统。
MiMo-V2-TTS 支持高质量的音色克隆能力。通过少量参考音频样本,模型能够学习目标音色的声纹特征,并在生成过程中保持音色一致性。强化学习阶段专门针对”更高质量的音色克隆”进行了优化,使克隆音色的稳定性和相似度都有显著提升。
MiMo-V2-TTS 能够智能识别文本中的标点符号、语气词、强调标记等信号,并将其自动转化为对应的语音表达方式,无需人工额外标注。这意味着同样一段文本,带有感叹号、省略号、引号等的内容,模型会自动赋予更恰当的语气和节奏。
在标准普通话场景下,MiMo-V2-TTS 的表现相当流畅,发音准确、气息自然,停顿点的处理比传统 TTS 更接近人类说话习惯。长句处理时韵律连贯,不会出现那种”读完一段再重新起音”的机械分段感。情绪层面的基础表达(如疑问句上扬、陈述句平稳、感叹句有力度)也都能准确还原。
方言支持是 MiMo-V2-TTS 最具辨识度的能力。在实际体验中,河南话和四川话的腔调特征明显,不是那种”只改了几个音节”的伪方言,而是连语调走向和节奏感都有地道还原。粤语的声调体系本身就比普通话复杂(九声六调),模型在粤语场景下的整体表现也令人满意。
当然,方言合成目前仍有天花板——对于极具个人特色的地方口音变体,或是偏远地区的小方言,模型的泛化能力还有提升空间。
情感控制是整体体验中最能拉开差距的维度。MiMo-V2-TTS 在句内情感切换方面表现出色,能够在同一句话内自然完成从平静到激动、从严肃到幽默的过渡,不显突兀。但在极端情绪(如嚎啕大哭、爆发性愤怒)的表达上,生成结果还稍显保守,这或许是为了维持整体稳定性的主动平衡。
歌声合成方面,MiMo-V2-TTS 在节奏和音高的准确性上超出预期。对于节奏清晰、旋律简单的歌曲,合成结果富有表现力,并非机械的”念歌词”。当然,歌声合成的整体效果仍不及专业歌声合成系统(如 Diff-Singer、SO-VITS-SVC 等),但作为一个统一 TTS 模型的附加能力,已经属于行业领先水平。
MiMo-V2-TTS 已通过 platform.xiaomimimo.com 提供 API 接入,支持与 OpenClaw、OpenCode、KiloCode、Blackbox、Cline 等主流 AI 工具链集成。发布初期提供一周限时免费体验,对于开发者评估来说窗口足够。API 接口遵循业界通行规范,迁移成本不高。
TTS 赛道在 2026 年格外热闹,以下五款产品是目前与 MiMo-V2-TTS 最直接的竞争对手,逐一拆解。
ElevenLabs 是目前全球影响力最大的商业 TTS 平台之一。其最新版本 Eleven v3 引入了情感标签控制系统(如 [excited]、[whispers]、[sighs]),支持 70+ 种语言,并开放了多说话者对话生成能力。在影视配音、有声书制作等内容创作场景,ElevenLabs 有着完善的工作流集成和丰富的音色库。
然而,ElevenLabs 的定价体系偏向商业用户,月费从 $5 到 $330 不等,且数据全部处于云端,本地化部署不被支持。最关键的是,它对中文方言的支持极为有限,在面向中文用户的本土化场景中存在明显短板。与 MiMo-V2-TTS 相比,ElevenLabs 更擅长英语内容和多语言国际化,但在中文深度、方言覆盖和情感控制粒度上均不占优。
Qwen3-TTS 是阿里云 Qwen 团队于 2026 年 1 月发布的开源多语言语音合成模型,支持 10 种语言、3 秒声纹克隆、97ms 超低延迟流式输出,其双轨流式架构(25Hz 与 12.5Hz 两个版本)分别面向长文本稳定生成和实时交互场景。在说话人相似度指标上,Qwen3-TTS 在全部 10 种语言中均超越了 MiniMax 和 ElevenLabs。
Qwen3-TTS 的优势在于完全开源(Apache 2.0 许可证)、可本地部署、延迟极低,适合对隐私敏感或需要高度定制的开发者。但其情感控制能力以”情感克隆”为主(即从参考音频继承情绪),缺乏 MiMo-V2-TTS 那种基于自然语言指令的主动情感控制能力;方言覆盖上,也没有 MiMo-V2-TTS 的多方言原生支持;更不具备歌声合成能力。
CosyVoice 是阿里达摩院推出的开源语音合成框架,发展到 3.0 版本后已具备双向流式建模、情感与风格控制、多方言支持(四川话、上海话、粤语等)等能力,首包延迟可压至 150ms,在行业内与微软 Azure TTS 并列被认为是商业落地稳定性的标杆。
CosyVoice 的核心优势是工程化成熟度高,有大量生产环境落地案例,开源社区活跃,适合企业级部署。但它的情感表达依赖指令词(哭腔、机器人音等预设类型),缺乏 MiMo-V2-TTS 那种多粒度、句内连续变化的情感控制颗粒度;此外,歌声合成也不在 CosyVoice 的能力范围内。
Fish Speech 是一款高音质开源 TTS 模型,支持 80+ 种语言,音频质量在开源模型中属于第一梯队,支持行内情感标签(inline emotion tags)进行细粒度情感控制,零样本克隆能力也属上乘。
Fish Speech 的主要制约在于许可证问题——其商业使用限制让不少团队在选型时犹豫;此外,其命令行推理需要两步管线(语义 token 生成 → wav 转换),部署便利性不如单步推理方案。语言覆盖上,Fish Speech 更偏向多语言国际化,对中文方言的专项支持深度不及 MiMo-V2-TTS;歌声合成同样不是它的设计目标。
MiniMax 的 TTS 模型 Speech-02 在国际权威语音评测榜单 Artificial Analysis 上曾登顶,一举超越 OpenAI 和 ElevenLabs,是国产商业 TTS 赛道上不可忽视的玩家。Speech-02 在音质和自然度方面有扎实的技术积累,延迟约 120ms,商业化成熟度高,已被大量内容创作和客服场景采用。
MiniMax 的劣势在于:与 MiMo-V2-TTS 一样属于云端 API 服务,定价从 $10/月起,对高频使用的团队成本敏感;方言支持上,MiniMax 整体上不如 MiMo-V2-TTS 丰富;歌声合成与多粒度情感控制也并非其核心卖点。但 MiniMax 已有更长时间的商业打磨,在稳定性和产品完整度上目前仍有一定优势。
| 对比维度 | MiMo-V2-TTS | ElevenLabs v3 | Qwen3-TTS | CosyVoice 3.0 | Fish Speech | MiniMax Speech-02 |
|---|---|---|---|---|---|---|
| 中文方言支持 | ✅ 5种(东北/川/豫/粤/台湾腔) | ❌ 有限 | ⚠️ 部分 | ✅ 3-4种 | ⚠️ 有限 | ⚠️ 有限 |
| 句内情感切换 | ✅ 多粒度自然切换 | ✅ 标签式 | ⚠️ 克隆式 | ⚠️ 预设类型 | ✅ 行内标签 | ⚠️ 基础 |
| 歌声合成 | ✅ 支持音高/节奏 | ❌ | ❌ | ❌ | ❌ | ❌ |
| 音色克隆 | ✅ | ✅ | ✅ 3秒克隆 | ✅ | ✅ | ✅ |
| 开源/本地部署 | ❌ API | ❌ API | ✅ 完全开源 | ✅ 开源 | ✅ 开源 | ❌ API |
| 流式低延迟 | 待公开 | ~150-300ms | 97ms | 150ms | ❌ 两步推理 | ~120ms |
| 多语言国际化 | 中文为主 | 70+语言 | 10种语言 | 中文为主 | 80+语言 | 多语言 |
| 强化学习优化 | ✅ 多维度RL | 未公开 | ✅ | ❌ | ❌ | 未公开 |
| 商业授权 | 待定 | 需付费订阅 | Apache 2.0 | Apache 2.0 | 限制商用 | 付费API |
最适合 MiMo-V2-TTS 的场景,大致可以分为以下几类:
智能硬件与车载系统:小米本身的生态包括智能手机、小爱音箱、智能家居和汽车,MiMo-V2-TTS 天然适配这些端侧交互场景,方言能力在本土化用户体验上尤为突出,东北话的智能音箱和四川话的车载导航,不再是笑话,而是实际可交付的功能。
有声内容创作:有声书、播客、短视频配音对自然度和情感表达的要求极高,MiMo-V2-TTS 的多粒度情感控制和方言支持,为这类场景提供了远超传统 TTS 的创作空间。歌声合成能力更是打开了 AI 原创音乐内容的可能性。
Agent 交互层:小米将 MiMo-V2-TTS 定位为 Agent 时代的语音合成基础设施,与 MiMo-V2-Pro 的推理能力和 MiMo-V2-Omni 的多模态理解能力配合,构成完整的感知-理解-输出链路。在面向用户的对话 Agent 场景中,高自然度、低机械感的语音输出是用户留存的关键因素之一。
客服与情感计算:客服场景对语气匹配、情感共情有硬性要求。MiMo-V2-TTS 能够根据对话内容自动调整语气,并在必要时切换至更有温度的情感表达,这对于降低客服人力成本、提升用户满意度都有直接价值。
任何模型都有能力边界,MiMo-V2-TTS 也不例外。目前已知的几个待优化点值得关注:
开源状态未定:与 Qwen3-TTS、CosyVoice 的完全开源不同,MiMo-V2-TTS 目前以 API 形式提供服务,本地部署方案尚未公开。对于隐私敏感型企业或需要离线部署的场景,这是一个实质性的限制。
流式延迟数据未公开:Qwen3-TTS 的 97ms 首包延迟已经是公开技术指标,CosyVoice 的 150ms 也有明确数据,而 MiMo-V2-TTS 的流式性能参数目前没有公开,对于实时交互场景的选型有一定不确定性。
英语及多语言能力有限:MiMo-V2-TTS 的设计重心是中文,在英语和其他语言的表现上,ElevenLabs、Fish Speech 等国际化产品有明显优势。面向海外用户或多语言混合场景时,需要评估是否匹配。
极端情感表达保守:在情感谱的两端(极度兴奋或极度悲痛),当前模型的输出倾向于稳健,而非最大化情感冲击力,这在某些需要高戏剧性表达的内容制作场景中会感受到上限。
商业授权细节待明确:发布初期的一周免费体验之后,完整的定价策略和商业授权条款需要进一步官方说明,这影响企业选型的决策稳定性。
单独看 MiMo-V2-TTS,它已经是一款能力均衡、亮点突出的语音合成模型;但放到小米整个 MiMo-V2 系列的生态框架中来看,它的意义更为深远。
MiMo-V2-Pro 负责复杂推理和 Agent 任务执行,MiMo-V2-Omni 负责多模态感知(文本+图像+视频+音频统一理解),MiMo-V2-TTS 则作为”嘴巴”负责将信息转化为自然语音输出。三者协作,构成了一个从感知到理解到表达的完整 Agent 闭环。
小米官方已明确表示,未来 MiMo-V2-TTS 将扩展多语言覆盖,并与 MiMo-V2-Omni 的多模态理解能力深度融合。这意味着未来的版本可能实现:看到一张图片,理解图片内容,然后用带有地域腔调的自然语音描述出来——这在智能家居、教育陪伴、无障碍辅助等场景的想象空间相当大。


